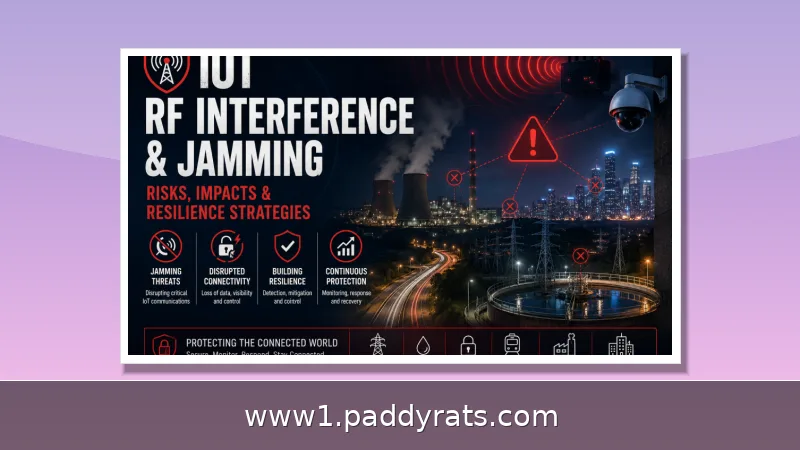
Wenn Jamming die Funkstrecke blockiert, meldet ein IoT-Sensor keinen Fehler – er sendet einfach nichts. Wer Telemetrie widerstandsfähig machen will, muss Failover unterhalb der Anwendungsebene planen, mit Redundanz, automatischer Erkennung und Hot Standby.
Warum Jamming IoT-Telemetrie in Stille verwandelt
Fällt die Funkstrecke aus, sendet ein gestörter Sensor einfach gar nichts – keine Fehlermeldung, keinen Alarm, keinen auffälligen Messwert. Das Cloud-Monitoring erwartet aber, dass Daten ankommen, und verbucht fehlende Pakete meist nur als Lücke, nicht als Ausfall. Das ist die eigentliche Falle: Die Ursache zeigt sich als Abwesenheit, nicht als Kennzahl. Wer Sensornetzwerke betreibt, sollte Resilienz deshalb unterhalb der Anwendungsebene ansetzen – auf der Funk- und Netzwerkschicht, wo die Verbindung tatsächlich reißt.
Jamming setzt im Grunde den Rauschpegel hoch, überfährt einen Kanal mit Leistung oder baut Interferenzmuster auf – und schon kann der Empfänger die Signale nicht mehr sauber dekodieren. Dabei muss der Angriff nicht mal besonders breit angelegt sein: Es reicht, wenn er auf eine einzelne Frequenz zielt, ein ganzes Band belegt oder ein bestimmtes Protokollmuster nachahmt. Was heißt das konkret für den Betrieb? Die Telemetrie verstummt, Steuerbefehle kommen verzögert an, und die Abstimmung zwischen verteilten Geräten fällt auseinander. Oft hält so eine Störung nur ein paar Sekunden an – aber genau in diesen Sekunden können sicherheitsrelevante Daten über die Leitung gehen. Deshalb zählt am Ende weniger die Frage, ob eine Störung überhaupt auftritt, sondern wie schnell das System nach ihr wieder greifbar ist.
Die Bedrohung ist längst nicht mehr nur theoretisch. Allein in den ersten vier Monaten des Jahres 2025 zählte die Luftfahrtberichterstattung weit über 120.000 Flüge, die von GNSS-Störungen betroffen waren. Rund um Vilnius meldeten Piloten im vierten Quartal 2024 mehr als 800 Störfälle – im Vorjahreszeitraum waren es noch 124. Finnair setzte 2024 die Flüge nach Tartu in Estland aus, weil wiederholte Ausfälle Landungen schlicht unmöglich machten. Und im September 2025 wurde ein Flug mit der Präsidentin der Europäischen Kommission über Bulgarien gestört. Im März 2026 legten EASA und EUROCONTROL dann einen gemeinsamen Aktionsplan vor, der davon ausgeht, dass die Störungen anhalten werden. Die Aufgabe wird dort als Resilienz verstanden, nicht als Beseitigung des Problems.
Wie Jamming-Angriffe Sensor- und Steuerdatenverkehr treffen
Jamming-Angriffe lassen sich zunächst nach ihrem Verhalten unterscheiden: Konstantes Jamming belegt einen Kanal dauerhaft mit Energie, während reaktives Jamming erst dann aktiv wird, wenn ein gültiges Signal erkannt wird. Das stört die Paketzustellung, ohne den Angreifer lange zu exponieren. Dazu kommen täuschende und zufällige Varianten. Nach Frequenzziel trennt man außerdem Breitband-, Punkt- und Sweep-Jamming. Für Betreiber ist vor allem eines wichtig: Reaktives Jamming ist besonders heimtückisch, weil es in Messreihen wie sporadischer Paketverlust aussieht – und damit klassische Schwellenwert-Alarme schlicht unterläuft.
Jamming kann Authentifizierungsaustausche unterbrechen, Telemetrie unterdrücken, Steuerbefehle verzögern und die Koordination zwischen verteilten Geräten aus dem Takt bringen. Trägt die Funkstrecke Authentifizierungs- oder Steuerdatenverkehr, entsteht schnell ein Zeitfenster, in dem Betreiber die Sicht verlieren oder Systeme auf schwächeres Verhalten zurückfallen. Genau deshalb ist Jamming keine reine Funkstörung, sondern eine Verfügbarkeitsschwäche: Die Abhängigkeit von Funk wird in dem Moment zum Risiko, in dem ein Angreifer die physische Ebene kontrolliert. Ein sauberes Failover-Design muss dieses Fenster so kurz wie möglich halten – und darf dabei keine unsicheren Bypässe erzwingen.
Ein wichtiger Nebeneffekt, der oft übersehen wird: Jamming kann gleichzeitige Eindringversuche oder unautorisierte Geräteaktivitäten verdecken. Wer nach einem Störfall also nur die Verbindung wiederherstellt und den Datenverkehr ungeprüft weiterlaufen lässt, übersieht womöglich einen Vorfall, der während der Störung stattgefunden hat. Deshalb sollten Recovery-Prozesse immer eine Kompromittierungsprüfung beinhalten – zum Beispiel den Abgleich von Geräteverhalten, Konfigurationsständen und ungewöhnlichen Paketmustern, bevor der normale Betrieb wieder aufgenommen wird.
Welche Funkträger exponiert sind: Mobilfunk, NTN, LoRaWAN und GNSS
Nicht jede Funktechnik ist gleich anfällig, doch jede bietet eine physische Angriffsfläche. Lizenzierter Mobilfunk genießt rechtlichen Schutz und wird vom Netzbetreiber überwacht – auf kurze Distanz lässt er sich trotzdem stören. Bei Satelliten- und NTN-Signalen kommt ohnehin nur ein schwaches Signal aus dem Orbit an, was sie für Störungen besonders empfänglich macht. LoRaWAN wiederum nutzt ein unlizenziertes, konkurrenzbasiertes ISM-Band (in Großbritannien und der EU bei 868 MHz), ohne dass ein Gerät exklusiven Anspruch darauf hätte. Studien zeigen: Sowohl gezieltes, billiges Jamming als auch versehentliche Gleichkanalinterferenz setzen der Technik zu. GNSS ist da der mahnende Fall – Jamming und Spoofing gehören in weiten Regionen inzwischen zum Alltag, und zahlreiche IoT-Geräte sind für Zeit und Position darauf angewiesen.
Die folgende Übersicht ordnet die wichtigsten Träger danach ein, wie gut sie geschützt sind und welcher Exposition sie typischerweise ausgesetzt sind. Eine standortspezifische Risikoanalyse kann sie natürlich nicht ersetzen – als erste Orientierung für die Wahl von Primär- und Backup-Pfaden taugt sie aber allemal.
| Funkträger | Schutzstatus | Typische Exposition | Failover-Eignung |
|---|---|---|---|
| Lizenzierter Mobilfunk (LTE-M, NB-IoT) | rechtlich geschützt, operatorüberwacht | nahbereichs-störbar | gut als Primärpfad, zweiter Anbieter als Backup |
| Satellit / NTN | reguliert, aber schwaches Signal | hoch bei schwacher Empfangslage | sinnvoll für abgelegene Standorte |
| LoRaWAN (868 MHz) | unlizenziert, konkurrenzbasiert | Jamming und Ko-Kanal-Interferenz | Frequenzsprung und Kanalwechsel nötig |
| GNSS | zivil frei nutzbar | Jamming und Spoofing verbreitet | nicht als alleinige Zeit-/Positionsquelle |
Aus der Tabelle lässt sich eine ziemlich einfache Entwurfsregel ableiten: Kein einzelner Funkträger sollte zum Single Point of Failure werden. Wer seine Telemetrie über LoRaWAN laufen lässt, sollte deshalb einen zweiten Pfad über Mobilfunk oder Satellit einplanen. Und wer GNSS für Zeitstempel verwendet, braucht eine lokale Zeitquelle als Rückfalllösung. Mehrere Technologien zu kombinieren ist also kein Luxus, sondern schlicht die Grundlage jeder Jamming-Resilienz.
Bausteine des Failover-Designs: Redundanz, Erkennung und Hot Standby
Failover meint die Fähigkeit, beim Ausfall des primären Kommunikationskanals oder Netzes auf einen Backup-Kanal umzuschalten. Dahinter steckt mehr als ein einzelner Schalter: Es braucht Redundanz über mehrere Mobilfunknetze, WLAN und Protokolle hinweg, eine automatische Erkennung über verlorene Pakete, Timeouts und ausbleibende Heartbeats sowie einen nahtlosen Übergang mit Wiederverbindung und fortgesetzter Übertragung. Dazu kommen eine Prioritätslogik – etwa von Mobilfunk zu WLAN und weiter zu einem zweiten Anbieter –, Lastverteilung über mehrere Pfade, die Gesundheitsüberwachung der Backups, Konfiguration und Fernverwaltung und nicht zuletzt regelmäßige Tests und Validierung.
Besonders wirksam ist Hot Standby mit vorab authentifizierten Schnittstellen. Im ROS-2-Testbett hielt das Framework zwei physische Interfaces in Hot Standby und führte den Failover durch automatisierte Aktualisierungen der Netzwerk-Routing-Tabelle aus. Sobald ein Jamming-Ereignis erklärt wurde, leitete das System ausgehende Telemetrie und Steuerdatenverkehr um, indem es die Linux-Standardroute änderte. Der entscheidende Punkt: Die Backup-Schnittstelle war bereits authentifiziert und verbunden, sodass im Störfall kein zeitaufwendiger Neuaufbau nötig war.
Diese Architektur lässt sich auf Sensornetzwerke übertragen. Statt bei Paketverlust eine Software-Neuassoziation anzustoßen, die Sekunden kostet, hält das Gerät oder Gateway mehrere Pfade betriebsbereit und schaltet auf Netzwerkebene um. Wichtig ist die Reihenfolge: Erkennung, Entscheidung, Umschaltung und Bestätigung müssen deterministisch ablaufen, damit ein kurzer Störimpuls nicht mehrere Wechsel hintereinander auslöst. Ein Mindesthaltezeitraum pro Pfad und eine Hysterese bei der Rückkehr zum Primärkanal verhindern Flattern und halten die Telemetrie stabil.
Gemessene Wiederherstellung: 141 ms Failover und 78,9 Prozent weniger Fehler
Die Zahlen aus dem ROS-2-Roboter-Testbett sind für die Praxis aussagekräftig: Hardware-gestütztes Failover stellte die Kommunikation im Durchschnitt in 141 ms wieder her. Gegenüber Software-Neuassoziation sank der gepoolte RMS-Fehler der Pfadverfolgung um 78,9 Prozent. Umgerechnet bedeutet das: Eine Verbindung, die in weniger als einer Fünftelsekunde zurückkehrt, verhindert, dass ein mobiler Akteur seine Bahn verliert oder in einen unsicheren Zustand fällt – ein Unterschied, der bei fahrenden Robotern oder fördertechnischen Anlagen unmittelbar sicherheitsrelevant wird.
Ein zweiter Datenpunkt betrifft die Technologievielfalt: Ein technologieübergreifendes Anti-Jamming-Schema erzielte 78 Prozent Goodput, während ein technologieübergreifender Störsender aktiv war, und übertraf damit passive und zufällige Anti-Jamming-Ansätze. Die Botschaft ist klar: Wer nur eine Technik absichert, verliert gegen einen Angreifer, der mehrere Bänder gleichzeitig belegt. Wer dagegen mehrere Funktechnologien kombiniert und dynamisch umschaltet, hält einen nutzbaren Durchsatz aufrecht, auch wenn der Primärkanal blockiert ist.
Für die Dimensionierung von Sensor-Telemetrie heißt das, den Failover nicht nur funktional, sondern zeitlich zu spezifizieren. Eine Obergrenze von wenigen hundert Millisekunden ist realistisch, wenn die Backup-Schnittstelle vorgehalten und authentifiziert ist. Wer diesen Wert nicht erreicht, sollte zumindest Pufferung und lokale Vorverarbeitung einplanen, damit Daten nicht verloren gehen, sondern nach der Umschaltung nachgeliefert werden.
Erkennungssignale und Gegenmaßnahmen gegen Jamming
Erkennung ist die Voraussetzung jedes Failovers. Bewährte Signale sind ein sinkendes Packet Delivery Ratio (PDR), Anomalien bei RSSI und Signalstärke, ein steigendes Bad Packet Ratio (BPR), eine dauerhaft belegte Carrier Sensing Time (CST), unregelmäßige Paket-Zwischenankunftszeiten (IAT), Spektrumanalyse sowie Machine-Learning-Klassifikatoren, die intelligente Störsender unterscheiden. Adaptive, clusterbasierte LoRa-BLE-Verfahren kombinieren Erfolgsrate der Paketzustellung und RSSI-Schwankungen und wechseln das Protokoll dynamisch, um Wiederholungen zu senken und Energie zu sparen.
Auf der Gegenmaßnahmen-Seite stehen Frequenzsprungverfahren (FHSS), Leistungsregelung, Richtantennen, Kanalwechsel, Netzredundanz, Verschlüsselung und Authentifizierung, Störsender-Lokalisierung und adaptive Protokolle. Als kompensierende Kontrollen kommen alternative Frequenzen, Richtantennen, die physische Verlagerung von Gateways, verstärkte Standortüberwachung, Safe-Mode-Verhalten, lokale Pufferung und drahtgebundene Alternativen infrage. Entscheidend ist die Kombination: Eine einzelne Maßnahme lässt sich umgehen, ein geschichtetes Set aus Erkennung, Umschaltung und Gegenmaßnahme nicht ohne Weiteres.
Grenzen sollten ehrlich benannt werden. LoRaWAN-Jamming hat praktische Limits durch Frequenzsprung und große Sensorabstände, doch mit der Reifung der Technologie müssen Angriffsvektoren mitgedacht werden. Und jede Wiederherstellung sollte eine Kompromittierungsprüfung einschließen, weil Jamming concurrent intrusion maskieren kann. Systeme sind so zu gestalten, dass eine Störung keine unsicheren Bypässe erzwingt – Sicherheit darf nicht das erste Opfer der Verfügbarkeit werden.
Welche praktischen Schritte machen Sensor-Telemetrie jamming-resilient?
Aus den Bausteinen lässt sich eine pragmatische Reihenfolge ableiten. Zuerst wird der Primärpfad festgelegt und ein zweiter, unabhängiger Träger bestimmt – etwa Mobilfunk plus Satellit oder LoRaWAN plus Mobilfunk. Danach werden Erkennungsschwellen für PDR, RSSI, BPR und IAT definiert und mit Hysterese versehen. Anschließend wird der Hot Standby aufgebaut, inklusive vorab authentifizierter Schnittstellen und automatisierter Routing-Umschaltung. Abschließend folgen Lasttests mit simuliertem Jamming, eine dokumentierte Rückfalllogik und eine Kompromittierungsprüfung nach jedem Störfall.
Für Betreiber, die diesen Aufwand scheuen, lohnt der Blick auf die Kosten des Nichtstuns. Ein stiller Sensor liefert keine Daten, aber auch keinen Alarm – Fehler werden erst sichtbar, wenn Geschäftsprozesse stocken. Wer Telemetrie für Sicherheit, Logistik oder Infrastruktur nutzt, sollte Failover deshalb als Teil der Grundarchitektur behandeln, nicht als Nachrüstung. Die Luftfahrt hat vorgemacht, wie schnell eine zunächst Randerscheinung zum systemischen Risiko wird, das Behörden zu gemeinsamen Aktionsplänen zwingt.
Was bedeutet Failover in einer IoT-Bereitstellung?
IoT-Failover ist die Fähigkeit, bei Ausfall des primären Kommunikationskanals oder Netzes auf einen Backup-Kanal zu wechseln. Es beruht auf Redundanz, automatischer Erkennung verlorener Pakete oder Timeouts, nahtlosem Übergang, Prioritätslogik für Kanäle, Gesundheitsüberwachung der Backups und regelmäßigen Tests. In der Praxis entscheidet weniger die Zahl der Pfade als deren tatsächliche Betriebsbereitschaft: Ein Backup, das erst im Störfall authentifiziert wird, kostet Sekunden und damit wertvolle Telemetrie.
Wie schnell kann netzwerkschichtiges Failover die Telemetrie unter Jamming wiederherstellen?
In einem ROS-2-Testbett für mobile Roboter mit zwei vorab authentifizierten Schnittstellen im Hot Standby und automatisierten Routing-Tabellen-Updates lag die durchschnittliche Wiederherstellungszeit bei 141 ms. Diese subsekundäre Wiederherstellung führte zu einer Reduktion des gepoolten RMS-Fehlers der Pfadverfolgung um 78,9 Prozent gegenüber Software-Neuassoziation. Für sicherheitsrelevante Sensor- und Steuerdaten ist diese Größenordnung der Maßstab, an dem ein Failover-Konzept gemessen werden sollte.
Häufig gestellte Fragen zu Jamming und IoT-Failover
Warum sendet ein gestörter IoT-Sensor keinen Fehler, sondern schweigt?
Ein gestörter Sensor kann seine Telemetrie nicht über die Funkstrecke absetzen und sendet deshalb gar nichts statt einer Fehlermeldung. Cloud-Monitoring erwartet jedoch ankommende Daten; bei blockierter Funkschicht ist der Ausfall als Abwesenheit sichtbar, nicht als roter Messwert. Resilienz muss daher unterhalb der Anwendungsebene entworfen werden.
Wie wird Jamming in drahtlosen Sensornetzwerken erkannt?
Zur Erkennung dienen sinkende Packet Delivery Ratio, Anomalien bei RSSI und Signalstärke, ein steigendes Bad Packet Ratio, eine dauerhaft belegte Carrier Sensing Time, unregelmäßige Zwischenankunftszeiten der Pakete, Spektrumanalyse und Machine-Learning-Modelle, die intelligente Störsender klassifizieren. Adaptive Verfahren kombinieren Erfolgsrate der Zustellung und RSSI-Schwankungen.
Welche Funkträger sind bei Jamming besonders exponiert?
Lizenzierter Mobilfunk ist rechtlich geschützt und operatorüberwacht, auf kurze Distanz aber physisch störbar. Satelliten- und NTN-Signale kommen schwach aus dem Orbit. LoRaWAN nutzt ein unlizenziertes ISM-Band bei 868 MHz ohne Exklusivität. GNSS gilt als warnendes Beispiel, weil Jamming und Spoofing in großen Regionen bereits Routine sind.
Welche Bausteine gehören zu einem belastbaren Failover-Design?
Ein belastbares Design umfasst Redundanz über mehrere Netze und Protokolle, automatische Erkennung über Paketverlust und Timeouts, nahtlosen Übergang mit Wiederverbindung, Prioritätslogik zwischen Kanälen, Lastverteilung, Gesundheitsüberwachung der Backups, Fernverwaltung sowie regelmäßige Tests mit simuliertem Jamming und eine Kompromittierungsprüfung nach jedem Störfall.
Warum meldet ein IoT-Sensor bei Jamming keinen Fehler?
Ein gestörter Sensor kann seine Telemetrie nicht über die Funkstrecke absetzen und sendet deshalb gar nichts – keine Fehlermeldung, keinen Alarm. Cloud-Monitoring wertet fehlende Pakete oft nur als Lücke statt als Ausfall. Die Ursache zeigt sich also als Abwesenheit von Daten, nicht als Kennzahl, weshalb Resilienz unterhalb der Anwendungsebene geplant werden muss.
Was gehört zu einem wirksamen Failover-Design gegen Jamming?
Wirksam sind Redundanz über mehrere Funkträger, automatische Erkennung über verlorene Pakete, Timeouts und Heartbeats, nahtlose Umschaltung mit Wiederverbindung, Prioritätslogik, Lastverteilung, Gesundheitsüberwachung der Backups sowie regelmäßige Tests. Besonders wirksam ist Hot Standby mit vorab authentifizierten Schnittstellen, damit im Störfall kein zeitaufwendiger Neuaufbau nötig ist.