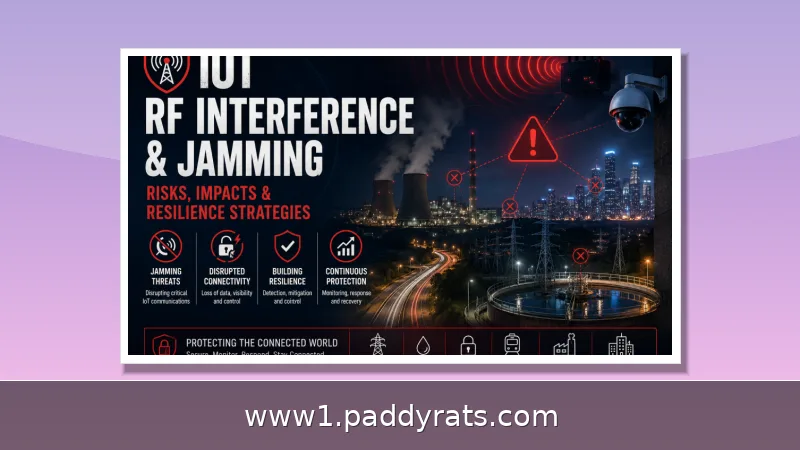
Quando o jamming bloqueia o enlace de rádio, o sensor não reporta erro: ele simplesmente fica em silêncio, e a resiliência precisa ser construída abaixo da camada de aplicação. Projetar failover de camada de rede, com detecção automática e hot standby, é o que mantém a telemetria fluindo sob interferência.
Por que o jamming transforma a telemetria IoT em silêncio
A primeira coisa que aprendi acompanhando implantações de sensores em campo é que o modo de falha mais perigoso não é o alarme vermelho no painel — é a ausência total de dados. Um dispositivo atingido por jamming não consegue atravessar o enlace de rádio, então não manda mensagem de erro nenhuma. A monitoração no estilo cloud parte do princípio de que a telemetria chega; quando a camada de rádio é negada, a falha aparece como silêncio, e não como métrica de alerta. É por isso que a resiliência precisa ser desenhada abaixo da camada de aplicação, no próprio caminho de comunicação.
O jamming eleva o piso de ruído, sobrepõe potência a um canal ou cria padrões de interferência que impedem o receptor de decodificar sinais — e isso vale tanto para uma frequência única quanto para uma faixa inteira ou um padrão de protocolo. Os efeitos, porém, vão muito além da perda de pacotes: trocas de autenticação podem ser interrompidas, comandos de controle acabam atrasados e a coordenação entre dispositivos distribuídos simplesmente quebra. Resultado: o operador perde visibilidade justamente no momento em que mais precisa dela.
Como os ataques de jamming interrompem o tráfego de sensores e controle
Dá para classificar esses ataques de duas formas: pelo comportamento e pela frequência que atingem. No comportamento, entram o jamming constante, o reativo, o enganoso e o aleatório. Já na frequência, temos o barrage (faixa larga), o spot (uma frequência pontual) e o sweep (varredura). Em ambientes com muitos sensores, o reativo é o mais traiçoeiro: ele só entra em ação quando percebe um sinal válido, o que atrapalha a entrega dos pacotes e, ao mesmo tempo, deixa o atacante quase invisível. Na prática, quem opera telemetria precisa lidar com uma consequência incômoda disso. O link pode parecer limpo quando ninguém está transmitindo e falhar justamente na hora do envio.
Os dados de campo e a literatura técnica deixam claro que a ameaça não é hipotética. Só na aviação, mais de 120 mil voos foram afetados por interferência em GNSS nos primeiros quatro meses de 2025. Perto de Vilnius, os pilotos relataram mais de 800 ocorrências de interferência no quarto trimestre de 2024 — contra 124 no mesmo período do ano anterior. Em 2024, a Finnair chegou a suspender os voos para Tartu, na Estônia, depois que apagões repetidos inviabilizaram os pousos; e em setembro de 2025 um voo que transportava a presidente da Comissão Europeia foi perturbado sobre a Bulgária. Já em março de 2026, EASA e EUROCONTROL publicaram um plano de ação conjunto que parte da premissa de que a interferência veio para ficar, encarando o desafio como uma questão de resiliência, e não de eliminação.
Quais portadores de rádio estão expostos: celular, NTN, LoRaWAN e GNSS
Cada tecnologia de transporte tem seu próprio perfil de exposição, e comparar esses perfis ajuda bastante na hora de decidir onde colocar redundância. O celular licenciado, por exemplo, é legalmente protegido e monitorado pela operadora — mas ainda pode ser fisicamente negado a curta distância. Sinais de satélite e NTN chegam fracos lá da órbita e carregam junto essa vulnerabilidade de sinal fraco. Já o LoRaWAN opera em banda ISM não licenciada, 868 MHz no Reino Unido e na União Europeia, uma faixa compartilhada e baseada em contenção, sem exclusividade; estudos mostram tanto jamming deliberado de baixo custo quanto interferência co-canal acidental degradando o enlace. E o GNSS é o conto de advertência: jamming e spoofing já viraram rotina em grandes regiões, e muitos dispositivos IoT dependem dele para tempo e posição.
| Portador | Proteção regulatória | Exposição típica | Papel no failover |
|---|---|---|---|
| Celular licenciado | Alta, monitorado por operadora | Negável a curta distância | Primário ou backup confiável |
| Satélite / NTN | Variável | Sinal fraco vindo da órbita | Backup para áreas remotas |
| LoRaWAN (ISM 868 MHz) | Baixa, banda compartilhada | Jamming barato e interferência co-canal | Primário de baixo consumo |
| GNSS | Limitada na prática | Jamming e spoofing rotineiros | Fonte de tempo/posição a diversificar |
Lendo essa tabela, a conclusão é direta: nenhum portador sozinho garante disponibilidade. O jamming transforma uma dependência de rádio em uma fragilidade de disponibilidade — e isso muda o cálculo. Quando o enlace transporta tráfego de autenticação ou de controle, a interrupção pode abrir uma janela em que os operadores perdem visibilidade ou os sistemas passam a operar com comportamentos mais frágeis. Por isso a arquitetura não pode se limitar a replicar o mesmo tipo de link: ela precisa combinar portadores com características diferentes, de modo que a falha de um não derrube toda a cadeia de comunicação.
Blocos de construção do failover: redundância, detecção e hot standby
Failover, na prática, é a capacidade de migrar de um canal ou rede primária para um backup quando o principal para de funcionar. Para isso dar certo, alguns elementos são indispensáveis: redundância — várias redes celulares, Wi-Fi, protocolos diferentes —, detecção automática baseada em pacotes perdidos, timeouts, heartbeats que deixam de chegar e perda de pacotes crescente, além de uma transição suave, com reconexão e retomada da transmissão. Também entram nessa conta a lógica de prioridade (celular para Wi-Fi e, depois, para outra operadora, por exemplo), o balanceamento de carga entre os caminhos, o monitoramento constante da saúde dos backups, a configuração e o gerenciamento remotos e, claro, testes e validações regulares.
O hot standby é a variante que mais me convence na prática. No framework ROS 2, mantêm-se duas interfaces físicas pré-autenticadas em espera ativa, e o failover acontece de forma instantânea por meio de atualizações automatizadas da tabela de rotas de rede. Quando um evento de jamming é declarado, o tráfego de telemetria de saída e de controle é redirecionado simplesmente modificando a rota padrão do Linux. A ideia central, aqui, é não ficar esperando a aplicação perceber o problema sozinha: a decisão ocorre na camada de rede, com as interfaces já autenticadas de antemão. Isso elimina o custo de reautenticação justamente no momento crítico, quando cada milissegundo conta.
Recuperação medida: failover em 141 ms e redução de erro de 78,9%
Quem ajuda a defender esse desenho são os números de um testbed de robô móvel com ROS 2. Nele, o failover assistido por hardware recuperou a comunicação em 141 ms, em média, enquanto a re-associação por software ficou bem atrás. No agregado, isso significou uma queda de 78,9% no erro de rastreamento de trajetória em RMS agrupado. Na prática, um failover abaixo de um segundo evita que o dispositivo perca o fio da meada no meio da perturbação — o que pesa muito quando o enlace transporta comandos de controle, e não só leituras de sensores.
Há também evidência de que a diversidade tecnológica compensa. Um esquema antijamming entre tecnologias entregou 78% de goodput mesmo com um jammer de tecnologia cruzada presente, superando abordagens passivas e antijamming aleatórias. Para mim, a lição é que a escolha não é entre uma tecnologia forte e outra fraca, mas entre uma arquitetura que troca de caminho com rapidez e uma que depende de um único enlace. A combinação de hot standby, detecção precoce e lógica de prioridade é o que transforma esses números em operação real.
Sinais de detecção e controles de mitigação para jamming
A detecção precisa olhar para vários indicadores ao mesmo tempo, porque nenhum sozinho é conclusivo. A queda na razão de entrega de pacotes (PDR), anomalias de RSSI ou força de sinal, aumento da razão de pacotes ruins (BPR), tempo de sensoriamento de portadora mostrando canal constantemente ocupado, intervalos irregulares entre pacotes (IAT), análise de espectro e classificadores de machine learning ajudam a identificar jammers inteligentes. Esquemas adaptativos baseados em cluster para LoRa-BLE detectam jamming usando taxa de sucesso de entrega e variações de RSSI, alternando protocolos dinamicamente para cortar retransmissões e economizar energia.
Do lado da mitigação, o repertório inclui frequency hopping, controle de potência, antenas direcionais, troca de canal, redundância de rede, criptografia e autenticação, localização do jammer e protocolos adaptativos. Como controles compensatórios, vale recorrer a frequências alternativas, antenas direcionais, realocação física de gateways, monitoramento de site mais forte, comportamento de modo seguro, buffer local e alternativas cabeadas. Em LoRaWAN, o jamming tem limites práticos por causa do frequency hopping e das longas distâncias dos sensores, mas esses vetores devem ser considerados à medida que a tecnologia amadurece. Por fim, o jamming pode mascarar intrusão concorrente ou comportamento não autorizado de dispositivo, então a recuperação deve incluir revisão de comprometimento e jamais forçar bypasses inseguros.
Como aplicar isso na prática sem cair em armadilhas
Minha recomendação prática é tratar o silêncio como sintoma de primeira classe. Se um sensor deixa de enviar dentro de uma janela esperada, isso deve disparar a lógica de failover antes de qualquer alarme de aplicação. Combine portadores com perfis distintos, mantenha as interfaces de backup pré-autenticadas e teste a troca regularmente, porque um backup nunca validado é apenas uma suposição. Documente a ordem de prioridade e monitore a saúde dos caminhos secundários, já que um backup degradado dá falsa sensação de segurança.
Também vale desconfiar de métricas de nuvem que só reagem à chegada de dados. Elas são úteis para o playbook de monitoramento, mas não substituem a detecção na camada de rede. A postura que EASA e EUROCONTROL adotaram para a aviação, de resiliência em vez de eliminação, se aplica bem ao IoT: não se trata de impedir todo jamming, e sim de garantir que a telemetria continue chegando por outro caminho quando o principal for negado.
Perguntas frequentes sobre failover e jamming em IoT
O que significa failover em uma implantação de IoT?
Failover em IoT é a capacidade de trocar de um canal ou rede de comunicação primária para um canal de backup quando o primário falha. Ele depende de redundância, detecção automática de pacotes perdidos ou timeouts, transição suave, lógica de prioridade entre canais, monitoramento de saúde dos backups e testes regulares de validação.
Quão rápido o failover de camada de rede restaura a telemetria sob jamming?
Em um testbed de robô móvel com ROS 2 usando duas interfaces pré-autenticadas em hot standby e atualizações automatizadas de tabela de rotas, a recuperação da comunicação levou em média 141 ms. Essa restauração abaixo de um segundo gerou redução de 78,9% no erro de rastreamento de trajetória em RMS agrupado, comparado à re-associação por software.
Como o jamming é detectado em redes de sensores sem fio?
A detecção usa queda na razão de entrega de pacotes, anomalias de RSSI ou força de sinal, aumento da razão de pacotes ruins, tempo de sensoriamento de portadora indicando canal ocupado, intervalos irregulares entre pacotes, análise de espectro e modelos de machine learning que classificam jammers inteligentes. Esquemas adaptativos combinam taxa de sucesso de entrega e variação de RSSI.