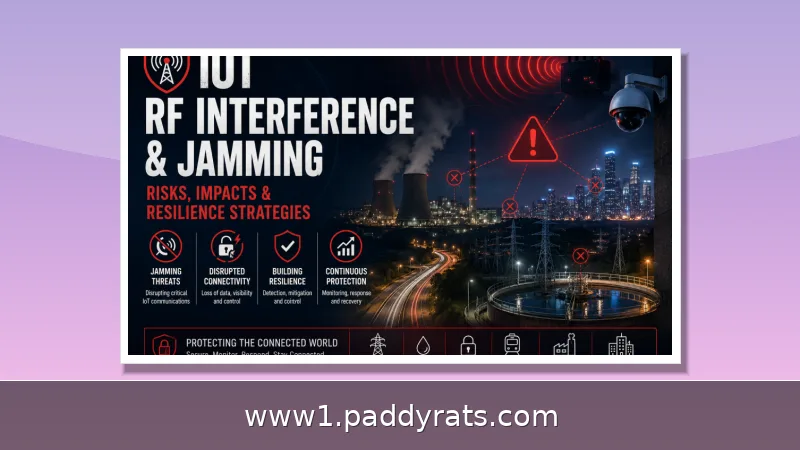
Når radiojamming blokerer forbindelsen, sender en IoT-sensor ingenting frem for en fejlmeddelelse, og derfor skal robustheden bygges under applikationslaget. Her er de konkrete byggeklodser til netværkslagets failover, detektion og hot standby med målte data bag.
Hvorfor jamming gør IoT-telemetri til tavshed
Det mest oversete aspekt ved radiojamming mod IoT er nok, at den ramte sensor ikke melder en fejl tilbage. Den sender ganske enkelt ingenting. Og mange skybaserede overvågningssystemer er bygget ud fra den antagelse, at telemetri nu engang ankommer — så når den ikke gør, står man tilbage med et tomt hul i stedet for en rød metrik. Robustheden skal altså designes under applikationslaget, i radio- og netværkslaget, hvor forbindelsen faktisk kan skifte.
Jamming virker ved at hæve støjniveauet, overdøve en kanal eller skabe interferensmønstre, som gør det umuligt for modtageren at afkode signalet. Angrebet kan være målrettet mod én bestemt frekvens, et helt bånd eller et protokollmønster. Men konsekvensen er sjældent bare tabt telemetri – forsinkede kontrolkommandoer og brudt koordination mellem distribuerede enheder hører også med. Og bærer forbindelsen autentificering eller styretrafik, opstår der hurtigt et vindue, hvor operatørerne mister overblikket, eller hvor systemerne falder tilbage til en svagere adfærd. Tavsheden er med andre ord selve symptomet, og det er den, overvågningen skal lære at genkende.
Hvordan jammingangreb forstyrrer sensor- og styretrafik
Man kan dele jammingangreb op efter, hvordan de opfører sig, og efter hvilke frekvenser de sigter mod. Ser vi på adfærden, findes der konstante, reaktive, bedrageriske og tilfældige angreb – og især den reaktive type er værd at bemærke, fordi den først vågner, når der faktisk registreres et gyldigt signal. Det gør den svær at få øje på, samtidig med at den forstyrrer pakkeleveringen med minimal eksponering af angriberen. Kigger vi i stedet på frekvensmålretningen, skelner man mellem barrage, spot og sweep. Fælles for dem alle er, at de angriber den fysiske kanal, som sensoren er afhængig af – uanset hvor sofistikeret resten af opsætningen ellers er.
I praksis betyder det, at jamming forvandler en afhængighed af radio til en svaghed i tilgængeligheden. Et angreb kan afbryde autentificeringsudvekslinger, kvæle telemetrien, forsinke kontrolkommandoer og rive koordinationen mellem enheder fra hinanden. Og det er ikke det eneste problem: jamming kan samtidig sløre, at nogen er ved at trænge ind, eller at en enhed opfører sig uautoriseret. Derfor bør en gendannelse også indeholde en gennemgang for kompromittering. Det handler ikke kun om at få forbindelsen tilbage — systemet må ikke være designet sådan, at forstyrrelsen tvinger det over i usikre bypass-løsninger.
Hvilke radiobærere er udsatte: mobil, NTN, LoRaWAN og GNSS
Licenseret mobiltelefoni er beskyttet af loven og bliver overvåget af operatøren, men det kan altså stadig blokeres fysisk på tæt hold. Satellit- og NTN-signaler kommer svagt ned fra kredsløb, så de arver den samme sårbarhed over for svage signaler. LoRaWAN ligger i et ulicenseret ISM-bånd – 868 MHz i EU og Storbritannien – hvor der er kontention, og ingen har eksklusivitet. Undersøgelser viser, at både bevidst lavpris-jamming og utilsigtet interferens fra sameksistens svækker LoRaWAN. Og GNSS er selve advarselseksemplet: jamming og spoofing er efterhånden rutine i store regioner, samtidig med at rigtig mange IoT-enheder er afhængige af netop det til tid og position.
Luftfartsdata viser med al tydelighed, hvor stort problemet er blevet. Alene i de første fire måneder af 2025 blev over 120.000 flyvninger påvirket af GNSS-interferens. Og ser man nærmere på Vilnius-området, rapporterede piloterne mere end 800 interferenstilfælde i fjerde kvartal 2024 – mod blot 124 i samme periode året før. Det er en voldsom stigning. Finnair måtte i 2024 indstille flyvningerne til Tartu i Estland, fordi gentagne udfald gjorde landingerne umulige, og i september 2025 blev en flyvning med EU-Kommissionens formand forstyrret over Bulgarien. Myndighederne tager da også situationen alvorligt: I marts 2026 offentliggjorde EASA og EUROCONTROL en fælles handlingsplan, hvor man antager, at interferensen vil fortsætte, og derfor rammer opgaven som et spørgsmål om robusthed frem for eliminering.
Failover-byggeklodser: redundans, detektion og hot standby
Failover betyder, at systemet skifter fra en primær kanal over til en backup, når den primære svigter. Det lyder enkelt, men i praksis kræver det flere ting, der spiller sammen. Først og fremmest redundans – altså at der findes alternative veje såsom flere mobilnetværk, Wi-Fi og forskellige protokoller. Dernæst automatisk detektion, hvor man fanger tabte pakker, timeouts og manglende hjerteslag, så svigt opdages uden at nogen skal sidde og kigge på skærmen. Selve overgangen skal helst være sømløs, med genopkobling og genoptaget transmission, og der skal være en prioritetslogik, der for eksempel ruter trafikken fra mobil til Wi-Fi og videre til en anden mobiludbyder, hvis det bliver nødvendigt. Oveni det kommer lastbalancering mellem de forskellige stier, løbende sundhedsovervågning af backupkanalerne, fjernkonfiguration og ikke mindst regelmæssig test og validering – for en failover, der aldrig er blevet afprøvet, er ærligt talt ikke meget værd.
Et konkret eksempel finder man i ROS 2-miljøet, hvor to forudautentificerede fysiske interface holdes i hot standby, og hvor failover sker øjeblikkeligt ved at routingtabellen i netværket opdateres automatisk. Når en jamminghændelse blev erklæret, blev udgående telemetri og styretrafik nemlig omdirigeret ved at ændre Linux-standardruten. Det viser, at failover på netværkslaget godt kan bygges som en selvstændig mekanisme, der ikke kræver ændringer i applikationen – men som til gengæld stiller krav om, at backupforbindelsen er forhåndsgodkendt og klar til brug.
Målt gendannelse: 141 ms failover og 78,9 % fejlreduktion
I et ROS 2-testbed med mobile robotter blev hardware-assisteret failover målt til i gennemsnit at gendanne kommunikationen på 141 ms. Det er hurtigt – og når man sammenligner med softwarebaseret re-association, gav det en reduktion på 78,9 % i den samlede RMS-fejl på stifølgningen. Pointen er, at sub-sekund gendannelse ikke bare er et teoretisk mål. Det er en målbar forskel for systemer, der skal holde kursen, mens radioen bliver angrebet.
Et andet resultat kommer fra en kryds-teknologisk anti-jamming-løsning, som opnåede 78 % goodput, selv når en kryds-teknologisk jammer var til stede, og dermed klarede sig bedre end passive og tilfældige anti-jamming-tilgange. Tallene peger på, at valget af failover-mekanisme og detektionsstrategi har direkte betydning for, hvor meget telemetri der overlever. For en udrulning betyder det, at man bør måle gendannelsestid og pakkeleveringsgrad som faste driftsmålinger, ikke kun som testresultater ved idriftsættelse.
Tabellen nedenfor opsummerer de centrale målinger og deres praktiske betydning.
Hvilke detektionssignaler og mitigeringstiltag virker
Detektion bygger på flere samtidige signaler: faldende pakkeleveringsgrad (PDR), anomalier i RSSI og signalstyrke, stigende andel af dårlige pakker (BPR), carrier sensing-tid der viser en konstant optaget kanal, uregelmæssige pakke-inter-ankomsttider (IAT), spektrumanalyse og maskinlæringsklassifikatorer, der kan skelne intelligente jammere. Adaptive klyngebaserede LoRa-BLE-løsninger kombinerer leveringssuccesrate og RSSI-variation og skifter protokol dynamisk for at skære ned på retransmissioner og spare energi.
Mitigering omfatter frekvensspring (FHSS), effektstyring, retningsbestemte antenner, kanalskift, netværksredundans, kryptering og autentificering, lokalisering af jammeren og adaptive protokoller. Kompenserende kontroller kan være alternative frekvenser, retningsbestemte antenner, fysisk flytning af gateways, stærkere siteovervågning, safe-mode-adfærd, lokal buffering og kablede alternativer. LoRaWAN har praktiske grænser for jamming på grund af frekvensspring og lange sensorafstande, men angrebsvektorer bør alligevel overvejes, efterhånden som teknologien modnes.
Sådan omsætter du failover-design til drift
I praksis bør du først kortlægge, hvilke radiobærere hver sensortype afhænger af, og hvilke der kan fungere som backup. Derefter definerer du detektionsregler, der kombinerer PDR, RSSI, BPR, carrier sensing-tid og IAT, så en jamminghændelse kan erklæres automatisk frem for at vente på en operatør. Hot standby med forudautentificerede interface og automatisk routingopdatering er den mekanisme, der gav de målte 141 ms, og den bør prioriteres, hvor kontrolkommandoer er tidskritiske.
Endelig skal backupkanalerne overvåges og testes regelmæssigt, og gendannelse bør altid følges op med en gennemgang for kompromittering, fordi jamming kan maskere andre angreb. Designet må ikke tillade, at forstyrrelsen tvinger systemet over i usikre bypass-løsninger. Ved at behandle tavshed som det primære fejlsignal og bygge failover under applikationslaget kan telemetrien holdes levende, selv når radioen angribes.
Sammenligning af radiobærere og deres failover-egnethed
Nedenstående tabel sammenligner de væsentligste bærere for IoT-telemetri med hensyn til eksponering og egnethed som backup. Den er tænkt som et beslutningsgrundlag, ikke som en udtømmende teknisk specifikation.
| Bærer | Eksponering | Styrke | Failover-egnethed |
|---|---|---|---|
| Licenseret mobil (LTE-M/NB-IoT) | Kan benægtes fysisk på tæt hold | Juridisk beskyttet og operatørovervåget | God som primær, kræver alternativ udbyder som backup |
| Satellit/NTN | Svage signaler fra kredsløb | Dækning uden for mobilnet | Velegnet som backup ved fjerntliggende sensorer |
| LoRaWAN (868 MHz EU) | Ulicenseret ISM med kontention | Lav effekt og lang rækkevidde | Kræver frekvensspring og sekundær protokol |
| GNSS | Jamming og spoofing er rutine | Tid og position | Bør ikke være eneste kilde til tid |
Tabellen viser, at ingen enkelt bærer er immun, og at failover-designet derfor bør kombinere mindst to teknologier med forskellige fysiske egenskaber. Den bør også tage højde for, at GNSS ikke kan betragtes som en pålidelig tidskilde alene, når jamming og spoofing er blevet rutine i store regioner.
En praktisk tommelfingerregel er at vælge backupkanaler, der ikke deler frekvensbånd eller infrastruktur med den primære, og at teste failover under realistiske interferensforhold frem for kun i laboratoriet.
Hvad koster tavshed i praksis?
Når telemetrien forsvinder, mister operatørerne synlighed på præcis det tidspunkt, hvor de har mest brug for den. Jamming kan samtidig maskere en samtidig intrusion eller uautoriseret enhedsadfærd, og derfor bør gendannelse altid omfatte en kompromitteringsgennemgang. Systemet skal designes sådan, at forstyrrelsen ikke tvinger det over i usikre bypass-løsninger, og sådan at lokale buffere og safe-mode-adfærd bevarer data og sikkerhed, indtil forbindelsen er genoprettet.
For teamet bag udrulningen betyder det, at failover ikke er et engangsprojekt. Backupkanaler skal overvåges, konfigureres centralt og testes regelmæssigt, og målinger som gendannelsestid og pakkeleveringsgrad bør indgå i den løbende drift. Det er den kombination af redundans, detektion og hot standby, der gør telemetrien robust, når radioen bliver angrebet.
Hvordan jamming opdages i trådløse sensornetværk
Detektion kræver flere samtidige indikatorer, fordi en enkelt metrik sjældent er entydig. Faldende PDR, stigende BPR, anomalier i RSSI, konstant optaget kanal via carrier sensing-tid og uregelmæssige pakke-inter-ankomsttider er de mest anvendte signaler. Til det kommer spektrumanalyse og maskinlæringsmodeller, der kan klassificere intelligente jammere, samt adaptive ordninger, der kombinerer leveringssuccesrate og RSSI-variation for at skelne jamming fra almindelig trafikbelastning.
I praksis bør detektionsreglerne kalibreres mod den konkrete udrulnings normale adfærd, så falske alarmer undgås. Når en hændelse erklæres, bør failover aktiveres automatisk, og telemetri og styretrafik omdirigeres til den forhåndsgodkendte backupkanal. Denne sammenkædning mellem detektion og handling er kernen i et jammingrobust design.
Hvad betyder failover i en IoT-udrulning?
IoT-failover er evnen til at skifte fra en primær kommunikationskanal eller netværk til en backupkanal, når den primære svigter. Det hviler på redundans, automatisk detektion af tabte pakker eller timeouts, sømløs overgang, prioritetslogik for kanaler, sundhedsovervågning af backups og regelmæssig test. Uden disse elementer vil et skift først ske, når en operatør opdager problemet, og det er for sent i mange anvendelser.
For telemetri betyder det, at failover skal kunne ske uden applikationsændringer og uden at tvinge systemet over i usikre tilstande. Hot standby med forudautentificerede interface og automatisk routingopdatering er en dokumenteret måde at opnå sub-sekund gendannelse på, og den bør indgå i designet, hvor kontrolkommandoer er tidskritiske.
Ofte stillede spørgsmål
Hvad betyder failover i en IoT-udrulning?
IoT-failover er evnen til automatisk at skifte fra en primær kommunikationskanal til en backupkanal, når den primære svigter. Det kræver redundans, detektion af tabte pakker eller timeouts, sømløs overgang, prioritetslogik og regelmæssig test. Uden disse elementer sker skiftet først, når en operatør opdager problemet, hvilket er for sent i mange anvendelser.
Hvordan opdages jamming i trådløse sensornetværk?
Detektion kræver flere samtidige indikatorer, fordi en enkelt metrik sjældent er entydig. Faldende pakkeleveringsgrad, stigende andel dårlige pakker, RSSI-anomalier, konstant optaget kanal og uregelmæssige pakke-inter-ankomsttider er centrale signaler. Hertil kommer spektrumanalyse og maskinlæringsmodeller, der kan klassificere intelligente jammere og skelne jamming fra almindelig trafikbelastning.
Hvorfor er tavshed farligere end en fejlmeddelelse?
Når jamming blokerer forbindelsen, sender sensoren ingenting frem for en fejlmeddelelse. Mange overvågningssystemer antager, at telemetri ankommer, og et tomt hul fremstår derfor ikke som en rød metrik. Tavshed kan desuden maskere en samtidig intrusion, så gendannelse bør altid følges op med en gennemgang for kompromittering.
Hvor hurtig kan hardware-assisteret failover gendanne forbindelsen?
I et ROS 2-testbed med mobile robotter blev hardware-assisteret failover målt til at gendanne kommunikationen på i gennemsnit 141 ms. Sammenlignet med softwarebaseret re-association gav det en reduktion på 78,9 procent i samlet RMS-fejl på stifølgning. Sub-sekund gendannelse er altså en målbar forskel for systemer, der skal holde kursen under angreb.