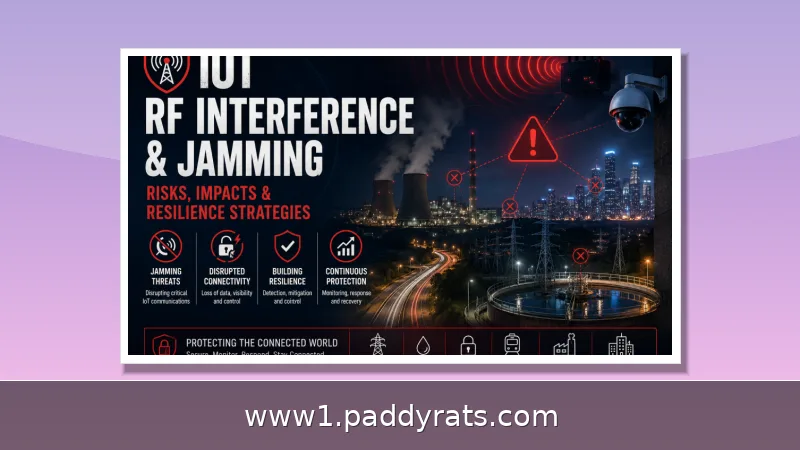
Il jamming non produce un errore: produce silenzio, e il monitoraggio cloud non vede il silenzio. Progettare il failover a livello di rete, con interfacce ridondanti in hot standby e rilevamento automatico, è l'unico modo per mantenere la telemetria dei sensori IoT disponibile quando lo spettro radio viene negato.
Perché il jamming trasforma la telemetria IoT in silenzio
Chi lavora con la telemetria industriale lo scopre presto, e spesso a sue spese: un dispositivo sotto jamming non manda un messaggio di errore, non manda niente e basta. Il segnale radio viene soffocato dal rumore, il ricevitore non riesce più a decodificare e la piattaforma di monitoraggio, che dà per scontato che la telemetria arrivi, non segnala un bell'allarme rosso: registra semplicemente un'assenza. È proprio questa asimmetria a rendere il jamming più insidioso di altri guasti, perché la metrica che dovrebbe avvisarci tace insieme al sensore. La resilienza, quindi, va costruita sotto il livello applicativo, dove si può ancora agire sulla radio e sul routing prima che il dato sparisca.
Come gli attacchi di jamming colpiscono traffico di sensori e comandi
Il jamming alza il rumore di fondo, sovrasta un canale o genera schemi di interferenza che impediscono al ricevitore di decodificare il segnale. Può prendere di mira una singola frequenza, un'intera banda oppure un pattern di protocollo, e in questo modo riesce a interrompere gli scambi di autenticazione, a sopprimere la telemetria, a ritardare i comandi di controllo e a spezzare il coordinamento tra dispositivi distribuiti. In fase di progetto conviene ragionare su due classificazioni: una per comportamento — costante, reattivo, ingannevole, casuale — e una per bersaglio in frequenza, cioè barrage, spot e sweep. Il jamming reattivo, però, è quello che dà più grattacapi: si attiva soltanto quando rileva un segnale valido, colpisce la consegna dei pacchetti e allo stesso tempo riduce al minimo l'esposizione dell'attaccante, tanto che diventa difficile distinguere un attacco da una semplice interferenza accidentale.
Quali portanti radio sono esposte: cellulare, NTN, LoRaWAN, GNSS
Non tutte le portanti radio hanno lo stesso profilo di rischio, e confrontarle è utile proprio per decidere la gerarchia di failover. Il cellulare su licenza è tutelato dal punto di vista legale e monitorato dall'operatore, però a corto raggio resta fisicamente negabile. Il satellite e le reti non terrestri, dal canto loro, arrivano dall'orbita con segnali deboli e si portano dietro la stessa fragilità. Poi c'è LoRaWAN, che lavora nella banda ISM non licenziata, 868 MHz nel Regno Unito e nell'UE: una banda condivisa, basata sulla contesa e senza esclusività, e gli studi documentano sia jamming deliberato a basso costo sia interferenza co-canale accidentale, entrambi capaci di degradarne le prestazioni. Il GNSS, infine, è l'avvertimento più chiaro di tutti: jamming e spoofing sono ormai routine su vaste regioni, e molti dispositivi IoT ci si appoggiano per tempo e posizione.
| Portante | Protezione legale | Esposizione al jamming | Ruolo nel failover |
|---|---|---|---|
| Cellular con licenza | Alta, monitorata dall'operatore | Negabile a corto raggio | Canale primario tipico |
| Satellite / NTN | Media | Segnale debole dall'orbita | Backup geografico |
| LoRaWAN 868 MHz | Bassa, banda ISM condivisa | Alta, jamming a basso costo | Telemetria a bassa potenza |
| GNSS | Variabile | Molto alta, jamming e spoofing diffusi | Solo tempo e posizione |
La tabella, in fondo, non ci dice che una portante sia meglio di un'altra: ci dice che nessuna è immune. E la lezione che arriva dal settore aeronautico è piuttosto chiara: la ridondanza va progettata dando per scontato che l'interferenza persista, non che prima o poi venga eliminata. In Italia e in Europa, concretamente, questo vuol dire mettere insieme più operatori cellulari, tenere un percorso LoRaWAN come fallback a basso consumo e, dove serve davvero, aggiungere un canale satellitare.
I blocchi costitutivi del failover: ridondanza, rilevamento e hot standby
Il failover, in pratica, sposta il traffico da un canale primario a uno di backup nel momento in cui il primo smette di funzionare. Gli ingredienti restano sempre quelli: ridondanza tra reti cellulari, Wi-Fi e protocolli diversi; rilevamento automatico basato su pacchetti persi, timeout, heartbeat che non arrivano e un tasso di perdita che sale; una transizione fluida, con riconnessione e ripresa della trasmissione; una logica di priorità, per esempio prima il cellulare, poi il Wi-Fi, poi un altro operatore; bilanciamento del carico tra i percorsi; monitoraggio costante dello stato dei backup; configurazione e gestione da remoto; e, ultimo ma non ultimo, test e validazione fatti con regolarità. Senza quest'ultimo passaggio, però, il backup rimane solo una speranza messa nero su bianco, non un percorso davvero verificato.
Il punto che separa un progetto davvero maturo da uno improvvisato è dove avviene lo switch. Se il failover lo lasci alla riassociazione software del middleware, i tempi si dilatano e il traffico di controllo finisce per risentirne. L'approccio hardware-assisted, invece, tiene due interfacce fisiche pre-autenticate in hot standby e cambia la rotta predefinita a livello di sistema operativo: nel momento in cui viene dichiarato l'evento di jamming, telemetria e comandi in uscita vengono reindirizzati all'istante, senza handshake applicativo e senza stare ad aspettare che l'applicazione si accorga del problema.
Recupero misurato: failover in 141 ms e riduzione del 78,9% dell'errore
Nel testbed ROS 2 con robot mobile, il failover hardware-assisted ha ripristinato la comunicazione in media in 141 ms. Ma il dato che conta davvero non è solo la velocità: rispetto alla riassociazione software, l'errore RMS di inseguimento del percorso si è ridotto del 78,9%. In pratica, il ritardo di commutazione si traduce direttamente in errore di traiettoria — e un ripristino sub-secondo cambia la qualità del controllo, non soltanto la disponibilità del dato. Pensiamo a un sistema che coordina più dispositivi: è proprio questa differenza a separare una flotta che continua a lavorare da una che si sfasa.
Uno schema anti-jamming cross-technology, in presenza di un jammer della stessa natura, è riuscito a garantire il 78% di goodput, battendo gli approcci passivi e casuali. Parliamo di numeri di laboratorio, sia chiaro, non di promesse da campo: però indicano una direzione precisa. La difesa che funziona, in sostanza, mette insieme diversità di tecnologia e decisioni rapide, invece di puntare tutto su un singolo accorgimento. E chi progetta telemetria per impianti distribuiti farebbe bene a trattare questi benchmark come obiettivi concreti da verificare nei propri test.
Segnali di rilevamento e controlli di mitigazione del jamming
Il rilevamento si basa su indicatori concreti: calo del packet delivery ratio, anomalie di RSSI e intensità del segnale, aumento del bad packet ratio, carrier sensing time che segnala un canale costantemente occupato, tempi di inter-arrivo dei pacchetti irregolari, analisi dello spettro e classificatori di machine learning capaci di riconoscere jammer intelligenti. Gli schemi adattivi basati su cluster per LoRa-BLE combinano tasso di successo nella consegna e variazioni di RSSI, e commutano dinamicamente protocollo per ridurre le ritrasmissioni e risparmiare energia. La chiave è non aspettare l'assenza totale: il degrado progressivo è il vero segnale precoce.
Sul fronte della mitigazione, l'elenco operativo comprende frequency hopping, controllo di potenza, antenne direttive, cambio di canale, ridondanza di rete, cifratura e autenticazione, localizzazione del jammer e protocolli adattivi. Ai controlli compensativi si aggiungono frequenze alternative, riposizionamento fisico dei gateway, monitoraggio più stretto del sito, comportamento in safe-mode, buffering locale e alternative cablate. Il punto di governo è che l'interruzione non deve mai spingere il sistema verso bypass insicuri: meglio un dispositivo che bufferizza e attende che uno che si riconnette a un canale non autenticato.
Rischi e limiti: il jamming può mascherare un'intrusione
C'è un rischio che raramente compare nei diagrammi di architettura: il jamming può mascherare un'intrusione concorrente o un comportamento non autorizzato del dispositivo. Se l'operatore perde visibilità proprio mentre qualcuno agisce, il ripristino della comunicazione deve includere una revisione della compromissione, non solo la riapertura del canale. Il jamming, inoltre, converte una dipendenza radio in una debolezza di disponibilità: se il collegamento trasporta traffico di autenticazione o di controllo, l'interruzione apre una finestra in cui i sistemi possono ricadere su comportamenti più deboli. LoRaWAN ha limiti pratici al jamming, tra frequency hopping e distanze lunghe dei sensori, ma i vettori di attacco vanno considerati man mano che la tecnologia matura.
Perché il silenzio è il sintomo che il monitoraggio cloud non vede
Le piattaforme di osservabilità sono ottime nel mostrare ciò che arriva e scarse nel mostrare ciò che non arriva. Una guida al monitoraggio cloud come quella di Datadog insegna a costruire metriche, alert e dashboard, ma l'assunzione implicita resta che la telemetria esista. Quando il livello radio viene negato, il fallimento è un'assenza, non una metrica rossa: serve un monitoraggio attivo della freschezza del dato, con heartbeat attesi, timeout espliciti e allarmi sull'intervallo di arrivo dei pacchetti. In pratica, la disponibilità va misurata dal lato di chi riceve, confrontando il numero atteso di sensori attivi con quello effettivamente presente.
Il contesto esterno conferma che l'interferenza non è un caso isolato. Nel settore aviation sono stati contati oltre 120.000 voli influenzati da interferenze GNSS nei primi quattro mesi del 2025; intorno a Vilnius i piloti hanno segnalato più di 800 casi di interferenza nel quarto trimestre 2024 contro 124 nello stesso periodo dell'anno precedente. Finnair ha sospeso i voli verso Tartu, in Estonia, nel 2024 dopo interruzioni ripetute, e a settembre 2025 un volo con a bordo la presidente della Commissione europea è stato disturbato sopra la Bulgaria. A marzo 2026 EASA ed EUROCONTROL hanno pubblicato un piano d'azione congiunto che assume la persistenza dell'interferenza, inquadrando il compito come resilienza e non come eliminazione.
Come impostare un piano di failover verificabile per la telemetria IoT
Un piano verificabile parte dalla mappa delle dipendenze radio e dalla gerarchia dei percorsi: quale canale è primario, quale backup, con quale priorità e con quale criterio si torna indietro. Poi si definiscono le soglie di rilevamento, si mantengono le interfacce di backup pre-autenticate e in hot standby, si automatizza l'aggiornamento della tabella di routing e si testa periodicamente con jammer controllati e scenari di interferenza co-canale. Ogni test deve misurare tempo di ripristino, packet delivery ratio e impatto sul controllo, perché il failover che non viene misurato non è un controllo, è un'ipotesi. La resilienza alla fine è un processo operativo, non una feature.
Domande frequenti sul failover per telemetria IoT sotto jamming
Le domande che riceviamo più spesso riguardano il comportamento atteso del dispositivo, la velocità del failover e i segnali da monitorare. Le risposte riassumono i punti trattati sopra e aiutano a impostare le verifiche in fase di progetto.
Domande frequenti
Perché un sensore IoT sotto jamming tace invece di segnalare un errore?
Un dispositivo sotto jamming non riesce a far passare la telemetria sul collegamento radio, quindi non invia nulla, nemmeno un messaggio di errore. Il monitoraggio di tipo cloud presume che la telemetria arrivi; quando il livello radio viene negato, la modalità di guasto è l'assenza, non una metrica rossa. Per questo la resilienza va progettata sotto il livello applicativo, con heartbeat attesi e allarmi sulla freschezza del dato.
Che cosa significa failover in una distribuzione IoT?
Il failover IoT è la capacità di passare da un canale o una rete di comunicazione primaria a un canale di backup quando il primario fallisce. Si basa su ridondanza delle reti e dei protocolli, rilevamento automatico di pacchetti persi o timeout, transizione senza interruzioni, logica di priorità tra canali, monitoraggio dello stato dei backup e test regolari. Senza verifica periodica il backup resta solo un'ipotesi.
Quanto è veloce il failover a livello di rete sotto jamming?
In un testbed ROS 2 con robot mobile, usando due interfacce pre-autenticate in hot standby e aggiornamenti automatici della tabella di routing, il ripristino della comunicazione è avvenuto in media in 141 ms. Questo ripristino sub-secondo ha prodotto una riduzione del 78,9% dell'errore RMS aggregato di inseguimento del percorso rispetto alla riassociazione software.
Come si rileva il jamming nelle reti di sensori wireless?
Il rilevamento usa il calo del packet delivery ratio, anomalie di RSSI o intensità del segnale, l'aumento del bad packet ratio, il carrier sensing time che mostra un canale costantemente occupato, tempi di inter-arrivo irregolari, analisi dello spettro e modelli di machine learning che classificano i jammer intelligenti. Gli schemi adattivi combinano tasso di successo nella consegna e variazione di RSSI per decidere quando cambiare protocollo.
Quali segnali indicano che un canale radio è sotto jamming?
I segnali precoci sono il calo del packet delivery ratio, anomalie di RSSI, aumento del bad packet ratio, carrier sensing time elevato, tempi di inter-arrivo irregolari e analisi dello spettro. Non bisogna attendere l'assenza totale: il degrado progressivo è il vero indicatore. La mitigazione combina frequency hopping, cambio canale, ridondanza di rete, autenticazione e buffering locale in safe-mode.